SSD(Single Shot Multibox Detector)をcolabで動かす
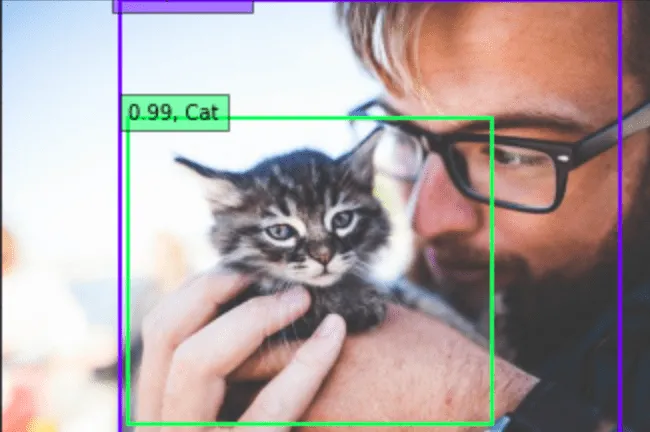
物体検出の手法SSDがあり、https://github.com/rykov8/ssd_keras に実装があるので、とりあえず動かしてみたいという話。手軽にgoogle colabを利用したいが、colabのTensorflow, Kerasのバージョンが新しくそのままでは動かない。そのためssd_kerasのREADME.mdにある通りに設定していく。また、ソースコード の書き換えをせずに実行するために、scipyのバージョンもv1.2.0以下にする。
対応方法
まずはcolabの現状を確認。
import platformprint('python: {}.{}.{}'.format(    platform.python_version_tuple()[0],    platform.python_version_tuple()[1],    platform.python_version_tuple()[2]))
import tensorflow as tfprint("tensorflow: " + tf.__version__)
import kerasprint("keras: " + keras.__version__)
import scipyprint("scipy " + scipy.__version__)
# output# python: 3.6.9# tensorflow: 2.4.0# keras: 2.4.3# scipy 1.4.1
そして、tensorflow、scipyをアンインストール。
pip uninstall tensorflow scipy
# 途中で Y/n を聞かれるので Y を入力
(重要)アンインストールを反映するために、ランタイムを再起動する。
ssd_kerasが動いたとされるバージョンのtensorflow、keras、scipyをインストールする。
pip install tensorflow==1.0.0 keras==1.2.2 scipy==1.0.0現状を確認する。
import platformprint('python: {}.{}.{}'.format(    platform.python_version_tuple()[0],    platform.python_version_tuple()[1],    platform.python_version_tuple()[2]))
import tensorflow as tfprint("tensorflow: " + tf.__version__)
import kerasprint("keras: " + keras.__version__)
import scipyprint("scipy " + scipy.__version__)
# output# python: 3.6.9# tensorflow: 1.0.0# Using TensorFlow backend.# keras: 1.2.2# scipy 1.0.0
git cloneする
!git clone https://github.com/rykov8/ssd_keras.git%cd ssd_kerasREADME.mdにあるリンクから学習済みデータをダウンロードしてssd_kerasディレクトリに保存する。あとはhttps://github.com/rykov8/ssd_keras/blob/master/SSD.ipynbを丸ごとコピペする。
import kerasfrom keras.applications.imagenet_utils import preprocess_inputfrom keras.backend.tensorflow_backend import set_sessionfrom keras.models import Modelfrom keras.preprocessing import imageimport matplotlib.pyplot as pltimport numpy as npfrom scipy.misc import imreadimport tensorflow as tf
from ssd import SSD300from ssd_utils import BBoxUtility
voc_classes = ['Aeroplane', 'Bicycle', 'Bird', 'Boat', 'Bottle',               'Bus', 'Car', 'Cat', 'Chair', 'Cow', 'Diningtable',               'Dog', 'Horse','Motorbike', 'Person', 'Pottedplant',               'Sheep', 'Sofa', 'Train', 'Tvmonitor']NUM_CLASSES = len(voc_classes) + 1
input_shape=(300, 300, 3)model = SSD300(input_shape, num_classes=NUM_CLASSES)model.load_weights('weights_SSD300.hdf5', by_name=True)bbox_util = BBoxUtility(NUM_CLASSES)
inputs = []images = []img_path = './pics/fish-bike.jpg'img = image.load_img(img_path, target_size=(300, 300))img = image.img_to_array(img)images.append(imread(img_path))inputs.append(img.copy())img_path = './pics/cat.jpg'img = image.load_img(img_path, target_size=(300, 300))img = image.img_to_array(img)images.append(imread(img_path))inputs.append(img.copy())img_path = './pics/boys.jpg'img = image.load_img(img_path, target_size=(300, 300))img = image.img_to_array(img)images.append(imread(img_path))inputs.append(img.copy())img_path = './pics/car_cat.jpg'img = image.load_img(img_path, target_size=(300, 300))img = image.img_to_array(img)images.append(imread(img_path))inputs.append(img.copy())img_path = './pics/car_cat2.jpg'img = image.load_img(img_path, target_size=(300, 300))img = image.img_to_array(img)images.append(imread(img_path))inputs.append(img.copy())inputs = preprocess_input(np.array(inputs))
preds = model.predict(inputs, batch_size=1, verbose=1)results = bbox_util.detection_out(preds)
import matplotlib.pyplot as pltfor i, img in enumerate(images):    # Parse the outputs.    det_label = results[i][:, 0]    det_conf = results[i][:, 1]    det_xmin = results[i][:, 2]    det_ymin = results[i][:, 3]    det_xmax = results[i][:, 4]    det_ymax = results[i][:, 5]
    # Get detections with confidence higher than 0.6.    top_indices = [i for i, conf in enumerate(det_conf) if conf >= 0.6]
    top_conf = det_conf[top_indices]    top_label_indices = det_label[top_indices].tolist()    top_xmin = det_xmin[top_indices]    top_ymin = det_ymin[top_indices]    top_xmax = det_xmax[top_indices]    top_ymax = det_ymax[top_indices]
    colors = plt.cm.hsv(np.linspace(0, 1, 21)).tolist()
    plt.imshow(img / 255.)    currentAxis = plt.gca()
    for i in range(top_conf.shape[0]):        xmin = int(round(top_xmin[i] * img.shape[1]))        ymin = int(round(top_ymin[i] * img.shape[0]))        xmax = int(round(top_xmax[i] * img.shape[1]))        ymax = int(round(top_ymax[i] * img.shape[0]))        score = top_conf[i]        label = int(top_label_indices[i])        label_name = voc_classes[label - 1]        display_txt = '{:0.2f}, {}'.format(score, label_name)        coords = (xmin, ymin), xmax-xmin+1, ymax-ymin+1        color = colors[label]        currentAxis.add_patch(plt.Rectangle(*coords, fill=False, edgecolor=color, linewidth=2))        currentAxis.text(xmin, ymin, display_txt, bbox={'facecolor':color, 'alpha':0.5})
    plt.show()
以上の手順でcolabで動作確認ができた。
その他
最初はDockerで手元で環境構築を進めていたが、pipでtensorflow==1.0.0のインストールに難航した。気まぐれにcolabで試すとすんなり動いた。
tensorflow==1.0.0だとGPU対応やTPU対応が面倒そうなので、v2で動くようにする。
スポンサーリンク
関連記事
スポンサーリンク